タグ: ローカルLLM

  • RAGが古い資料を答え続けるのを防ぐには?追加・差し替え・削除の更新設計

    RAGが古い資料を答え続けるのを防ぐには?追加・差し替え・削除の更新設計

    社内文書を検索できるRAGやAIチャットを作った直後は、問題なく回答できていた。

    ところが数か月後、料金表を更新したのに旧料金を答える。業務マニュアルを差し替えたのに、以前の手順を案内する。廃止した資料を共有フォルダから削除したのに、AIの回答には残っている。

    このような問題は、AIモデルの性能だけが原因ではありません。元のファイルを更新しても、RAG側の検索データが自動で最新になるとは限らないためです。

    RAGを業務で使い続けるには、導入時の文書登録だけでなく、導入後の「追加・差し替え・削除・期限切れ」を管理する必要があります。

    結論から言うと、最初に決めたいのは次の4点です。

    • どの文書が正式版か
    • 更新を誰がRAGへ反映するか
    • 旧版を検索対象から外す条件は何か
    • 反映後に何を質問して確認するか

    この記事では、小規模事業者や少人数チーム向けに、RAGの文書更新を無理なく続けるための実務設計を整理します。

    ファイルを上書きしただけではRAGが更新されないことがある

    RAGは、元のPDFやWordファイルを毎回そのまま読んで回答しているとは限りません。

    一般的には、文書を一定の長さに分割し、検索用のデータへ変換して、ベクトルデータベースや検索インデックスへ登録します。利用者が質問すると、その登録済みデータから関連部分を探し、AIが回答を作ります。

    そのため、共有フォルダのファイルを上書きしても、検索用データの作り直しや再登録が行われなければ、RAG側には古い内容が残ることがあります。

    反対に、元ファイルを削除しても、登録済みの分割データが残っていれば、検索結果に出続ける場合があります。

    RAGの文書更新では、元ファイルと検索データを別々に考えることが重要です。

    • 元ファイル: PDF、Word、Excel、Markdown、Webページなど
    • 検索用データ: 分割した文章、埋め込みデータ、メタ情報、検索インデックス
    • 回答画面: 利用者が質問し、参照元と回答を見る場所

    元ファイルだけ最新でも、検索用データが古ければ、AIの回答は古いままです。

    RAG運用で管理したい4つの更新イベント

    文書更新を「ファイルを入れ直す作業」とだけ考えると、削除や期限切れが抜けます。

    最低限、次の4つに分けて管理します。

    1. 新しい文書を追加する

    新しいマニュアル、FAQ、料金表、規程、提案資料などを検索対象へ追加するケースです。

    追加時には、ファイルを登録するだけでなく、次の点を確認します。

    • 誰が見てよい文書か
    • 正式版か、作業中の文書か
    • どのカテゴリや部署に属するか
    • いつから有効な情報か
    • 似た内容の旧文書が残っていないか

    新しい料金表を追加しても、旧料金表が同じ検索対象に残っていれば、AIは両方を見つける可能性があります。

    追加と同時に、置き換える旧文書がないか確認することが大切です。

    2. 既存文書を差し替える

    内容を修正したPDFやWordを上書きするケースです。

    差し替えでは、同じファイル名でも内容が変わっていることがあります。更新を検知したら、古い検索データを削除し、新しい内容で再登録する流れが必要です。

    この時、旧データを消さずに新データだけ追加すると、同じ文書の新旧が両方検索されることがあります。

    差し替え時に確認したい項目は次の通りです。

    • 文書IDは同じか
    • 版数や更新日は変わったか
    • 旧データを削除してから再登録したか
    • 参照元リンクは新しいファイルを指しているか
    • 変更した項目を質問して、新版の回答になるか

    3. 不要な文書を削除する

    元ファイルを削除しただけでは、検索用データが残る場合があります。

    削除時には、元ファイル、検索インデックス、ベクトルデータ、キャッシュ、参照元リンクの状態を確認します。

    完全に削除する必要がない場合は、検索対象から外す「無効化」でも構いません。監査や履歴のために旧版を残すなら、保管場所と検索対象を分けます。

    • 保管はするが、AI検索では使わない
    • 管理者だけが検索できる
    • 過去資料として明示し、通常回答では優先しない
    • 一定期間後に完全削除する

    「保管すること」と「回答に使うこと」を同じにしない設計が必要です。

    4. 期限切れや旧版として無効化する

    削除できない文書でも、現在の回答には使いたくないことがあります。

    たとえば、過去の料金表、旧契約条件、終了したキャンペーン、改定前の就業ルール、以前の製品マニュアルです。

    このような文書には、次のような情報を持たせます。

    • 有効開始日
    • 有効終了日
    • 最新版かどうか
    • 置き換え先の文書ID
    • 検索対象に含めるか

    日付や版数をファイル名だけに頼ると、表記の揺れや入力漏れが起きます。RAG側で扱えるメタ情報として持たせる方が、後から確認しやすくなります。

    最低限持たせたい文書管理項目

    大きな文書管理システムを導入しなくても、最初はスプレッドシートやCSVで管理できます。

    最低限、次の項目があると更新状態を追いやすくなります。

    • 文書ID
    • 文書名
    • 元ファイルの保存場所
    • カテゴリまたは対象業務
    • 版数
    • 最終更新日
    • 有効開始日・有効終了日
    • 文書の責任者
    • 閲覧できる利用者・部署
    • RAG登録状態
    • 最終登録日時
    • 検索対象に含めるか
    • 置き換え元・置き換え先の文書ID
    • 確認用のテスト質問

    特に重要なのは、文書ID、版数、RAG登録状態、テスト質問です。

    ファイル名が変わっても同じ文書だと判断できるIDがあれば、旧データの削除と新版の再登録を対応づけやすくなります。

    小さく始める更新フロー

    最初からGoogle DriveやNotionの全更新を自動同期する必要はありません。

    まずは、更新頻度が高く、古い回答の影響が大きい文書だけを対象にします。

    1. 更新対象の文書を3種類程度に絞る
    2. 正式版の保存場所を1つ決める
    3. 文書ID、版数、更新日、担当者を記録する
    4. 追加・差し替え・削除の申請方法を決める
    5. RAGへ再登録する担当者を決める
    6. 反映後にテスト質問を実行する
    7. 回答と参照元が新版になったことを確認する
    8. 確認日時を更新履歴へ残す

    対象にしやすいのは、料金表、問い合わせFAQ、業務マニュアル、サービス説明、製品仕様などです。

    これらは更新内容が明確で、テスト質問も作りやすいため、小さな運用を試すのに向いています。

    更新頻度は文書ごとに分ける

    すべての文書を毎日再登録すると、処理時間や確認作業が増えます。

    文書の性質に合わせて、更新方法を分けます。

    手動更新が向いている文書

    料金表、契約条件、社内規程など、変更頻度は低いものの、間違える影響が大きい文書です。

    更新時に人が内容を確認し、RAGへ反映した後、決めた質問で回答を確認します。

    定期更新が向いている文書

    週次レポート、月次資料、定期的に追加される議事録などです。

    毎日、毎週、毎月など決まった時間に変更ファイルを確認し、追加分だけ登録します。

    変更検知が向いている文書

    頻繁に更新されるFAQ、サポート文書、商品情報などです。

    ファイルの更新日時、ハッシュ値、版数などを使って変更を検知し、変更があった文書だけ再登録します。

    ただし、自動更新した後も、重要な文書は回答確認を省略しない方が安全です。

    RAG更新後はテスト質問で確認する

    再登録が成功したというログだけでは、回答が正しくなったとは限りません。

    検索では旧データが残っている、参照元リンクが切れている、似た文書が優先されている、といった問題が起きることがあります。

    文書ごとに1から3個のテスト質問を用意しておくと、更新後の確認がしやすくなります。

    たとえば料金表なら、次のような質問です。

    • 現在の基本料金はいくらですか
    • 追加費用が発生する条件は何ですか
    • この料金はいつから有効ですか

    マニュアルなら、変更した手順を直接聞きます。

    確認するのは、回答文だけではありません。

    • 最新版の内容を答えているか
    • 旧版の内容が混ざっていないか
    • 正しい文書名やURLが参照元に出ているか
    • 更新日や版数を確認できるか
    • 答えがない時に無理に作っていないか

    よくある失敗は「新しい文書を足すだけ」

    RAGの更新で多いのは、新版を追加して終わることです。

    旧版が残っていると、検索結果に新旧両方が出ます。AIが新版を必ず選ぶとは限りません。

    ほかにも、次のような失敗があります。

    • 同じ文書を何度も登録し、重複データが増える
    • ファイル名を変えたため、旧データと別文書として登録される
    • 削除した文書の分割データだけ残る
    • 更新担当者が不明で、誰も再登録しない
    • 自動同期は動いているが、回答確認をしていない
    • 参照元URLが旧ファイルのままになっている
    • ローカル環境と本番環境で登録内容が違う

    更新処理は、追加だけでなく、旧データの特定、削除、再登録、確認までを1セットにします。

    小型ツール化するなら最初に必要な機能

    文書数が増え、手作業での更新確認が難しくなったら、小型ツール化を検討できます。

    最初から複雑な管理画面は必要ありません。まずは次の機能で十分です。

    • 文書一覧
    • 版数と更新日の表示
    • RAG登録済み・未登録・更新待ちの状態管理
    • 追加・差し替え・削除の実行
    • 登録エラーの表示
    • テスト質問と確認結果の記録
    • 参照元リンクの確認

    その後、必要に応じて次の機能を追加します。

    • Google Driveや共有フォルダの変更検知
    • 更新担当者への通知
    • 期限切れ文書の警告
    • 重複ファイルの検出
    • 更新前後の回答比較
    • 部署や利用者ごとの権限制御

    重要なのは、自動化の範囲を広げることではなく、古い文書が回答へ混ざった時に原因を追えることです。

    相談前に整理するとよい情報

    RAGの文書更新や小型管理ツールを相談する場合は、次の情報があると範囲を決めやすくなります。

    • 現在使っているRAGやAIチャットの構成
    • 元文書の保存場所
    • ファイル形式と文書数
    • 更新頻度が高い文書
    • 削除できない旧版があるか
    • 古い回答が出た具体例
    • 文書を更新する担当者
    • 誰がAIチャットを使うか
    • クラウドへ出せない情報があるか
    • 手動更新と自動同期のどちらを希望するか

    完璧な仕様書は必要ありません。古い回答の例と、本来参照してほしい最新版が分かるだけでも、原因の切り分けを始められます。

    YOSHIO.devで相談できること

    YOSHIO.devでは、ローカルLLM・RAG環境構築、業務自動化、小型ツール開発について相談できます。

    「RAGが古い料金表を参照している」「文書を差し替えても回答が変わらない」「Google Driveの更新を小さく反映したい」「追加・削除・テスト確認を管理する画面が欲しい」といった段階でも、現在の文書と運用を見ながら整理できます。

    最初から全社文書を自動同期するのではなく、更新頻度が高い文書や、間違える影響が大きい文書だけに絞って試すことも可能です。

    まとめ

    RAGや社内AIチャットは、最初に文書を登録して終わりではありません。

    元ファイルを更新しても、検索用データが古いままなら、AIは旧版を答え続けることがあります。文書の追加、差し替え、削除、期限切れを分け、旧データの処理と更新後の質問確認までを運用に含める必要があります。

    小さく始めるなら、料金表、FAQ、業務マニュアルなど数種類に対象を絞り、文書ID、版数、更新日、RAG登録状態、テスト質問を管理します。

    RAGの品質は、モデル選びだけでなく、どの文書が現在有効なのかを継続して管理できるかで変わります。

    よくある質問

    元のPDFを上書きすれば、RAGの回答も自動で更新されますか?

    構成によります。元ファイルの変更を検知して検索用データを再作成する仕組みがなければ、RAG側には古い内容が残ることがあります。上書き後に旧データの削除、新版の再登録、テスト質問による確認が必要です。

    RAGから古い文書を削除するにはどうすればよいですか?

    元ファイルだけでなく、文書を分割して登録した検索インデックスやベクトルデータも対象にします。文書IDで登録データを追えるようにしておくと削除しやすくなります。履歴として残す場合は、保管場所とAI検索の対象を分けます。

    RAGの文書更新は毎日行うべきですか?

    すべての文書を毎日更新する必要はありません。料金表や規程は変更時に手動確認し、議事録やレポートは定期更新、FAQや商品情報は変更検知にするなど、文書の頻度と間違えた時の影響で分けると運用しやすくなります。

    Google DriveやNotionの更新をRAGへ自動反映できますか?

    APIや連携方法が利用できる構成なら可能です。ただし、変更ファイルを追加するだけでなく、差し替え前のデータ削除、権限、削除済み文書、更新後の回答確認まで設計する必要があります。最初は対象フォルダや文書種類を絞る方法が現実的です。

    小規模なRAGでも文書管理ツールは必要ですか?

    文書数が少ないうちはスプレッドシートでも管理できます。文書ID、版数、更新日、登録状態、担当者、テスト質問を記録できれば十分です。更新漏れや重複登録が増えた段階で、小型管理画面や変更検知を追加すると無駄が少なくなります。
  • AI議事録からタスクを自動登録する前に決めること|担当・期限・確認漏れを防ぐ設計

    AI議事録からタスクを自動登録する前に決めること|担当・期限・確認漏れを防ぐ設計

    AI議事録からタスク管理ツールへToDoを自動登録するなら、最初から完全自動化しないことが重要です。

    会議の要約は、読み返せる文章になっていれば役立ちます。しかしタスク登録には、「何をするか」「誰が担当するか」「いつまでか」「本当に決定したか」という確定情報が必要です。

    ここが曖昧なまま自動登録すると、誤担当、期限違い、二重登録、未決定事項のタスク化が起きます。

    最初は、AIがタスク候補を抽出し、人が担当者と期限を確認してから登録する半自動化がおすすめです。

    この記事では、小規模事業者や少人数チーム向けに、AI議事録からNotion、スプレッドシート、Backlog、Trelloなどへタスクを登録するときの設計を整理します。大きな会議管理システムではなく、会議後の転記作業を減らしながら確認漏れを防ぐための小さな仕組みです。

    AI議事録とタスクデータは別物

    AI議事録は、発言を要約し、話題ごとに整理し、決定事項らしい文章を抜き出す用途では便利です。

    ただし、読みやすい議事録ができたからといって、そのまま正しいタスクデータになるとは限りません。

    会議では、次のような言い方がよく出ます。

    • 「それは来週までに見ておきます」
    • 「デザイン側で一度確認しましょう」
    • 「できれば金曜までに欲しいです」
    • 「山田さんにも相談してから決めます」
    • 「この案で進めるか、次回もう一度話しましょう」

    人が聞けば文脈を補える場合でも、AIがタスクとして登録するには情報が足りません。

    「それ」が何を指すのか。「見ておく」の完了条件は何か。「来週」が何月何日なのか。「デザイン側」の誰が担当するのか。「欲しい」は正式な依頼なのか。「相談してから決める」は確定事項なのか保留なのか。

    議事録の文章をタスクへ変えるには、曖昧な会話を確定項目へ変換するルールが必要です。

    自動登録で起きやすい6つの失敗

    1. 検討案までタスクになる

    会議では、決まったことだけでなく、アイデアや仮案も話します。

    「LPの料金表を変える案もある」「問い合わせフォームを短くしてもよいかもしれない」といった発言をAIがToDoとして扱うと、まだ合意していない作業が管理表へ増えていきます。

    タスク候補には、最低でも次の状態を付けます。

    • 決定済み
    • 確認待ち
    • 提案・検討中
    • 見送り

    「決定済み」だけを登録対象にし、それ以外は候補一覧に残す設計が安全です。

    2. 担当者が別人になる

    会議中の「私がやります」「制作側で対応します」「担当に聞きます」といった表現は、文字起こしだけでは誰を指すか分からないことがあります。

    同姓の人がいる、表示名と社員名が違う、社外参加者がいる、といった場合も誤登録が起きやすくなります。

    担当者はAIに自由入力させるより、登録済みの担当者一覧から候補を選ばせます。一致しない場合は空欄または「要確認」にし、人が確定します。

    3. 「来週」「月末」の期限がずれる

    相対的な日付は、自動化で扱うときに注意が必要です。

    「来週の金曜」は、会議日を基準に計算する必要があります。「月末まで」は営業日を考えるのか、暦どおりなのかで変わります。「次回まで」は次回会議の日程が未定なら期限にできません。

    AIが期限を抽出するときは、元の表現と変換後の日付を両方残します。

    • 元の表現: 来週金曜まで
    • 会議日: 2026年6月11日
    • 変換候補: 2026年6月19日
    • 確認状態: 未確認

    変換後の日付だけを保存すると、あとから誤りに気づきにくくなります。

    4. 同じタスクが二重登録される

    会議の途中と最後で、同じ作業が言い直されることがあります。

    「トップ画像を差し替える」「ファーストビュー画像を新しくする」「新しいバナーへ変更する」が、実際には同じ作業を指している場合があります。

    AIが発言ごとにタスクを作ると、似たタスクが複数登録されます。登録前に、タスク名、対象案件、担当者、期限が近い候補をまとめて表示し、人が統合できるようにします。

    5. 修正された決定が古いまま残る

    会議では、最初に決めた内容が後半で変わることがあります。

    「金曜まで」と話したあと、「素材待ちなので月曜へ変更」と決まる場合です。議事録の前半だけを見てタスク化すると、古い期限が登録されます。

    同じ対象の発言が複数ある場合は、「変更前」「変更後」「変更理由」を確認できる形にします。最終決定が不明なら、自動登録せず要確認に止めます。

    6. 会議の機密情報が別サービスへ広がる

    議事録には、顧客名、見積金額、未公開施策、個人情報、契約条件などが含まれることがあります。

    文字起こしサービス、生成AI、タスク管理ツール、通知チャットを連携すると、会議データが複数のサービスを通ります。

    自動化前に、どの情報をどこへ渡すかを整理します。タスク登録に不要な会話全文や個人情報まで転送する必要はありません。

    タスク候補に持たせたい8つの項目

    AI議事録からタスクを作る場合、タスク名だけを抽出しても運用しにくくなります。

    最初は次の8項目をそろえると確認しやすくなります。

    1. タスク名: 何をするか
    2. 対象: どの案件、ページ、顧客、資料に関する作業か
    3. 担当者: 誰が実行するか
    4. 期限: いつまでか
    5. 確定状態: 決定済み、確認待ち、検討中のどれか
    6. 完了条件: どの状態になれば終わりか
    7. 根拠: 議事録内の該当発言や時間
    8. 登録状態: 未登録、確認済み、登録済み、重複候補など

    特に大切なのは、確定状態と根拠です。

    AIがなぜタスクだと判断したか分からないと、人が確認するたびに議事録全体を読み直す必要があります。該当箇所やタイムスタンプがあれば、短時間で確認できます。

    おすすめは「抽出・確認・登録」の3段階

    AI議事録のタスク化は、1回の処理で完了させるより、3段階に分けると安全です。

    1. AIがタスク候補を抽出する

    文字起こしや議事録から、AIがタスク名、担当者候補、期限候補、確定状態、根拠となる発言、不足情報を出します。

    この段階では、タスク管理ツールへ登録しません。

    2. 人が担当・期限・確定状態を確認する

    候補一覧を小型画面やスプレッドシートへ表示し、人が確認します。

    担当者を選ぶ。期限を日付に直す。検討案を外す。重複タスクをまとめる。完了条件を補う。

    人がゼロから議事録を読み、タスクを書き起こすのではなく、AIが作った候補を短時間で直す形です。

    3. 確認済みだけを登録・通知する

    確認済みになったタスクだけを、利用中の管理先へ登録します。

    • Notionのタスクデータベース
    • Googleスプレッドシート
    • Backlog、Trello、Asanaなどのタスク管理ツール
    • 社内の小型管理画面
    • メールやチャットへの担当者通知

    連携できる範囲は、利用中のツール、API、権限、契約プランによって変わります。最初はCSV出力やスプレッドシート登録だけにすると、小さく試しやすくなります。

    小型ツールに入れたい基本機能

    会議の回数が多く、毎回同じ確認をしているなら、小型ツール化を検討できます。

    最初から会議録画、文字起こし、AI要約、タスク登録、通知、進捗管理をすべて作る必要はありません。

    最小構成は次のようなものです。

    • 議事録を貼り付ける、またはファイルを読み込む
    • AIがタスク候補を抽出する
    • 担当者を登録済み一覧から選ぶ
    • 期限の元表現と変換日を並べて確認する
    • 決定済み、確認待ち、検討中を切り替える
    • 重複候補をまとめる
    • 確認済みだけを管理表へ登録する
    • 登録日時、確認者、元の議事録をログに残す

    この形なら、AIの役割は「候補作成」、人の役割は「確定」、ツールの役割は「登録と記録」と分けられます。

    使い始めてから、会議ツールとの連携、担当者通知、期限前リマインド、未確認タスク一覧、タスク管理ツールへのAPI登録などを追加できます。

    完全自動化してよいタスク、確認を残すタスク

    自動登録しやすいのは、毎週繰り返す定型作業、担当者が固定されている作業、期限の計算ルールが決まっている作業、失敗してもすぐ修正できる社内タスクです。

    一方で、次のタスクは人の確認を残した方が安全です。

    • 顧客への納期や約束に関わるもの
    • 見積、契約、請求、公開日に関わるもの
    • 複数部署や社外担当者が関わるもの
    • 担当者や期限が会話の中で変わったもの
    • 個人情報や機密情報を含むもの
    • 「検討する」「相談する」など完了条件が曖昧なもの

    完全自動化の判断基準は、AIの精度だけではありません。誤登録したときに気づけるか、戻せるか、影響が小さいかも確認します。

    ローカルLLMが向く場合

    会議内容を外部の生成AIへ渡しにくい場合は、ローカルLLMや社内環境での処理を検討できます。

    たとえば、顧客情報や未公開案件を扱う、会議データを外部サービスへ保存したくない、社内用語や案件名を含む議事録を処理したい、処理ログや保存期間を自分たちで管理したい場合です。

    ただし、ローカルで動かせば自動的に安全になるわけではありません。

    録音データ、文字起こし、AIの出力、登録先のタスク、処理ログを誰が見られるかを決める必要があります。モデルを動かすPCの性能、処理時間、文字起こし方法、バックアップも確認します。

    会議の機密度が低く、既存クラウドサービスの方が運用しやすい場合もあります。ローカルLLMは目的ではなく、情報の扱いと運用条件に合わせて選ぶ手段です。

    導入前に作るタスク化ルール表

    ツールを作る前に、簡単なルール表を作ると必要な機能が見えます。

    • 何をタスクとして扱うか
    • 検討案と決定事項をどう見分けるか
    • 担当者が不明なときは誰へ確認するか
    • 相対日付をどう変換するか
    • 期限がないタスクを登録するか
    • 完了条件が曖昧な場合はどうするか
    • 重複候補をどうまとめるか
    • どの情報をAIへ渡してよいか
    • どの管理ツールへ登録するか
    • 誤登録に気づいたとき誰が直すか

    ルールがないままツール連携だけを増やすと、会議の曖昧さがそのままタスク管理へ流れ込みます。

    YOSHIO.devで相談できること

    YOSHIO.devでは、業務自動化、小型ツール開発、ローカルLLM・RAG環境構築について相談できます。

    「議事録からタスク候補だけを作りたい」「スプレッドシートへの転記を減らしたい」「担当者と期限の確認画面が欲しい」「機密会議なのでローカル処理を検討したい」といった段階でも、現在の会議方法とタスク管理に合わせて小さく整理できます。

    最初から全部をつなぐのではなく、1つの会議、1つの議事録形式、1つの登録先から試すと、必要な確認ルールと自動化範囲を見極めやすくなります。

    よくある質問

    AI議事録だけで担当者と期限を正確に決められますか?

    会議内で担当者名と日付が明確に合意されていれば抽出しやすくなります。ただし、「私」「担当側」「来週」など曖昧な表現も多いため、最初はAIが候補を出し、人が確定する運用がおすすめです。

    議事録からタスク管理ツールへ直接登録できますか?

    登録先のAPIや権限が利用できれば連携できる場合があります。最初はスプレッドシートやCSVへ候補を出し、確認済みだけを登録する形にすると、誤登録や二重登録を確認しやすくなります。

    会議の決定事項と単なるアイデアをAIで分けられますか?

    「決定」「確認待ち」「提案」「見送り」などの分類候補を出すことはできます。ただし、会話だけでは合意状態が分からない場合もあるため、不明なものを自動確定せず、確認待ちに止めるルールが必要です。

    機密性のある会議でもAI議事録を使えますか?

    利用する文字起こし、生成AI、保存先、通知先ごとに、データがどこへ送られ、どれだけ保存されるかを確認する必要があります。外部送信を避けたい場合は、ローカル文字起こしやローカルLLMを含めて構成を検討できます。

    小規模なチームでも専用ツールを作る意味はありますか?

    会議後に毎回同じ転記や確認をしているなら、タスク候補の抽出、担当者選択、期限確認、登録だけに絞った小型ツールでも負担を減らせます。まずは既存のスプレッドシートを確認画面として使う方法もあります。

  • AIに個人情報を渡して大丈夫?業務自動化前に決めるマスキング設計

    AIに個人情報を渡して大丈夫?業務自動化前に決めるマスキング設計

    ChatGPTや社内AIを業務に使うとき、多くの人が最初に不安になるのが個人情報の扱いです。

    問い合わせメールをAIで要約したい。顧客対応の返信案を作りたい。社内文書をRAGで検索したい。スプレッドシートの行を見て次の対応を判断したい。

    どれも便利そうですが、そこには氏名、メールアドレス、電話番号、会社名、住所、契約内容、相談内容、社内メモなどが含まれていることがあります。

    「AIにそのまま貼り付けてよいのか」
    「ローカルLLMなら全部安全なのか」
    「どこまで伏せれば実用性が残るのか」

    このあたりを曖昧にしたままAI業務自動化を始めると、便利さより不安が勝ってしまいます。

    この記事では、小規模事業者や少人数チーム向けに、AIへ情報を渡す前に決めたいマスキング設計を整理します。ローカルLLM、RAG、問い合わせ対応AI、小型ツール開発を検討する前の準備メモとして使える内容です。

    AI導入で最初に決めるべきは「何をAIに見せないか」

    AI活用の相談では、「AIに何をさせるか」から話が始まりがちです。

    • 問い合わせ内容を要約したい
    • 返信文の下書きを作りたい
    • 社内文書を検索したい
    • 営業メモから次のアクションを出したい
    • スプレッドシートの内容を分類したい

    もちろん目的を決めることは重要です。ただし、業務で使うなら同じくらい大切なのが「AIに何を見せないか」です。

    たとえば問い合わせ対応であれば、AIが内容を理解するために必要な情報と、必ずしも見せなくてよい情報があります。

    • 相談内容の要約には、氏名そのものは不要なことが多い
    • 返信案の作成には、メールアドレスは不要なことが多い
    • 緊急度の分類には、電話番号は不要なことが多い
    • 見積もり前の整理には、具体的な住所を伏せても進められることが多い

    AIに渡す情報を減らしても、業務上の判断に必要な意味が残るなら、先に減らすべきです。

    マスキング設計とは、単に黒塗りすることではありません。AIが仕事をするために必要な文脈を残しながら、個人情報や機密情報を渡しすぎない形へ変換する設計です。

    まず分けたい3種類の情報

    AIに渡す前の情報は、次の3種類に分けると整理しやすくなります。

    • そのまま渡してよい情報
    • 置き換えれば渡せる情報
    • AIに渡さない情報

    この分類をせずに「全部危ない」または「全部そのままでよい」と考えると、AI活用が進みにくくなります。

    そのまま渡してよい情報

    個人や取引先を特定しない一般的な説明、公開済みのサービス情報、社内で共有して問題ない業務手順などは、そのままAIに渡せる場合があります。

    例:

    • 公開中のサービスページ本文
    • 一般的なFAQ
    • 個人名を含まない業務手順
    • テンプレート化された返信文
    • 公開前チェックリスト

    ただし、公開情報に見えても、社内用の価格条件や未公開のキャンペーン情報が混ざっていることがあります。公開済みかどうかだけでなく、外部に出してよい内容かを確認します。

    置き換えれば渡せる情報

    AIに内容を理解してほしいが、具体的な個人情報までは必要ない場合は、置き換えが有効です。

    例:

    • 山田太郎 → 顧客A
    • example@example.com → メールアドレス
    • 東京都渋谷区の具体住所 → 東京都内
    • 株式会社〇〇 → 取引先A
    • 090-xxxx-xxxx → 電話番号
    • 注文番号や契約番号 → 管理番号

    ここで大切なのは、意味を残すことです。

    たとえば「東京都渋谷区神南…」という住所を完全に消すと、地域対応の判断ができなくなるかもしれません。その場合は「東京都内」「関東エリア」のように粒度を落として残します。

    氏名を「顧客A」「顧客B」に置き換えると、会話の流れは保ちながら個人名を出さずに済みます。

    AIに渡さない情報

    AIに渡さなくても業務が進む情報、漏れると影響が大きい情報、社内ルール上入力できない情報は、最初から除外します。

    例:

    • 本人確認に使う情報
    • 詳細な住所や電話番号
    • クレジットカードや銀行口座
    • パスワード、APIキー、認証情報
    • 未公開の契約条件
    • 医療、法務、労務など慎重な扱いが必要な相談内容

    AIに入力する前に、人が毎回判断する運用では抜け漏れが起きやすくなります。できればフォーム、スプレッドシート、社内ツール側で自動的に除外・置換する仕組みを作る方が安定します。

    マスキングで実用性を落とさないための考え方

    個人情報を伏せるときに起きやすい失敗は、伏せすぎてAIが判断できなくなることです。

    たとえば、問い合わせ文を次のようにすべて伏せてしまうと、AIは何も判断できません。

    「□□□について□□□したいです。□□□までに□□□をお願いします。」

    これでは個人情報は消えていますが、業務自動化には使えません。

    実用性を残すには、次のように置き換えます。

    「LP制作について相談したいです。来月中旬までに公開したいです。現在のサイトURLと参考LPがあります。」

    この文章なら、個人名や連絡先がなくても、相談カテゴリ、希望時期、必要資料は分かります。

    マスキングでは、次の3点を意識します。

    • 誰かを特定する情報は伏せる
    • 業務判断に必要な属性は粒度を落として残す
    • AIの出力に戻してはいけない情報は最初から渡さない

    AIに渡す文章は、元データのコピーではなく、業務判断用の安全な要約にするイメージです。

    問い合わせ対応AIでのマスキング例

    問い合わせ対応は、AI業務自動化の入り口になりやすい領域です。

    ただし、問い合わせには個人情報が入りやすいため、そのままAIへ渡す前に変換を考えます。

    元の問い合わせ:

    「山田太郎です。example@example.com から連絡しています。東京都渋谷区で美容室を運営しています。今のLPから予約が増えず、7月末までにリニューアルしたいです。予算は50万円前後です。」

    AIに渡す形:

    「顧客Aからの問い合わせ。業種は美容室。課題はLPから予約が増えないこと。希望は7月末までのLPリニューアル。予算感は50万円前後。返信案では、現状LPのURL、予約導線、参考サイト、希望する撮影有無を確認する。」

    この形なら、氏名やメールアドレス、詳細住所を渡さずに、返信案の作成に必要な情報を残せます。

    AIに任せる処理は、次のような範囲に絞ると始めやすくなります。

    • 相談カテゴリの分類
    • 不足情報の抽出
    • 返信案の下書き
    • 担当者向けメモの作成
    • スプレッドシート用の要約

    最終返信や見積もり確定は、人が確認する運用にしておくと安全です。

    RAGや社内文書検索では「文書ごとに伏せ方」を変える

    RAGや社内文書検索では、PDF、議事録、マニュアル、FAQ、契約関連資料などをAIが参照することがあります。

    このとき、すべての文書を同じ扱いにすると危険です。

    まずは文書を次のように分けます。

    • 公開してよい資料
    • 社内共有してよい資料
    • 部署や担当者を限定する資料
    • 個人情報や契約情報を含む資料
    • AI検索に入れない資料

    RAGでは、検索対象に入れた文書が回答の根拠になります。AIの回答だけをチェックしても、検索対象の文書が広すぎると事故が起きます。

    個人情報を含む文書は、次のような対策を検討します。

    • AI検索用に個人情報を削除した版を作る
    • 顧客名や担当者名をIDに置き換える
    • 参照できるユーザーを制限する
    • 回答に原文を長く引用させない
    • 参照元リンクを出し、人が確認できるようにする
    • 質問ログと回答ログを保存し、危険な回答を見直せるようにする

    ローカルLLMを使う場合でも、文書の整理や権限設計が不要になるわけではありません。外部送信の不安は下げられますが、社内の誰が何を見られるか、ログをどう扱うかは別問題です。

    ローカルLLMなら個人情報の問題は解決するのか

    ローカルLLMは、社内PCや自社管理の環境でAIを動かせるため、クラウドAIにデータを送ることへの不安を下げやすい選択肢です。

    ただし、「ローカルLLMなら何を入れても大丈夫」という意味ではありません。

    注意したい点は次の通りです。

    • 端末やサーバーに誰がアクセスできるか
    • 入力ログや回答ログを保存するか
    • 保存したログに個人情報が残らないか
    • RAG用の文書フォルダに不要な資料が混ざらないか
    • バックアップや共有フォルダから漏れないか
    • モデルやツールの更新時に設定が変わらないか

    ローカルLLMは、個人情報対策の選択肢の一つです。マスキング、権限、ログ、運用ルールと組み合わせて考える必要があります。

    クラウドAIを使う場合も、ローカルLLMを使う場合も、最初に「AIへ渡す前の形」を決めておくことが重要です。

    小さく始めるなら「AIに渡す前の変換ツール」を作る

    個人情報対策を毎回手作業でやると、続きません。

    最初の小型ツールとしておすすめしやすいのが、AIに渡す前の変換ツールです。

    たとえば、次のような流れです。

    1. フォームやメール本文を貼り付ける
    2. 氏名、メール、電話番号、住所、管理番号を検出する
    3. 顧客A、メールアドレス、電話番号、地域名などに置き換える
    4. AIに渡す用の要約文を作る
    5. 必要なら元データと置換後データを別々に保存する

    このような小型ツールがあると、担当者ごとに伏せ方が変わる問題を減らせます。

    スプレッドシート連携にするなら、個人情報列をAI処理から除外し、必要な列だけをAIへ渡す形にできます。

    問い合わせフォームと連携するなら、送信直後にAI処理用の安全な要約を作り、担当者通知には元情報とAI要約を分けて表示できます。

    重要なのは、AIそのものを大きく作り込む前に、AIへ渡す入力を整えることです。

    マスキング設計のチェックリスト

    AI業務自動化やRAG導入を検討する前に、次の項目を確認します。

    • AIに渡す情報の種類を一覧化したか
    • 氏名、メール、電話番号、住所、契約番号などを検出できるか
    • そのまま渡す情報、置き換える情報、渡さない情報を分けたか
    • 置き換え後も業務判断に必要な意味が残るか
    • AIの出力に個人情報を再表示しない設計になっているか
    • ログに元データを残すか、残すなら誰が見られるか
    • RAGの検索対象に入れる文書を選別したか
    • ローカルLLMとクラウドAIの使い分けを決めたか
    • 最終送信や見積もりなど、人が確認する工程を残したか
    • 運用中に危険な入力や回答を見直す仕組みがあるか

    このチェックリストが埋まっていない状態でAIに本番データを渡すと、あとから運用を止めることになりやすくなります。

    逆に、最初に小さく決めておけば、問い合わせ対応、社内文書検索、スプレッドシート自動化などへ広げやすくなります。

    YOSHIO.devで相談できること

    YOSHIO.devでは、小規模事業者や少人数チーム向けに、AI業務自動化、ローカルLLM・RAG環境構築、小型ツール開発、LP制作の相談を受けています。

    個人情報や社内情報を扱うAI活用では、最初から大きなシステムを作るよりも、次のような小さな設計から始める方が現実的です。

    • AIに渡す情報の棚卸し
    • 個人情報のマスキングルール整理
    • 問い合わせ文のAI要約・返信案作成フロー
    • スプレッドシートからAIへ渡す列の整理
    • RAGに入れる文書と入れない文書の分類
    • ローカルLLMとクラウドAIの使い分け設計
    • 小型の変換ツールや管理画面の試作

    「AIを使いたいが、個人情報をどこまで入れてよいか分からない」「社内文書検索を試したいが、情報の扱いが不安」という段階でも相談できます。

    まずは、AIに任せたい業務、今使っているフォームやスプレッドシート、AIへ渡すのが不安な情報を整理しておくと、具体的な提案につなげやすくなります。

    ローカルLLM・RAG環境構築サービス、業務自動化サービス、お問い合わせページから、現在の業務内容に合わせてご相談ください。

    まとめ

    AIに個人情報を渡してよいかどうかは、AIツールの種類だけで決まるものではありません。

    大切なのは、AIへ渡す前に情報を分けることです。

    • そのまま渡してよい情報
    • 置き換えれば渡せる情報
    • AIに渡さない情報

    この3つを決めるだけでも、AI業務自動化の不安はかなり減らせます。

    ローカルLLMやRAGを使う場合でも、マスキング、権限、ログ、文書選別は必要です。クラウドAIを使う場合は、なおさら入力前の変換が重要になります。

    最初から完璧なAIシステムを作る必要はありません。まずは、問い合わせ文やスプレッドシートの一部を安全な形に変換し、AIに要約や分類を任せる小さな流れから始めてみてください。

    FAQ

    ChatGPTに顧客名やメールアドレスを入力してもよいですか?

    業務内容や利用するAIサービス、社内ルールによって判断が変わります。少なくとも、返信案作成や要約に不要な氏名、メールアドレス、電話番号、詳細住所は、入力前に置き換えることをおすすめします。

    マスキングするとAIの精度は落ちませんか?

    伏せすぎると精度は落ちます。重要なのは、個人を特定する情報は伏せつつ、業務判断に必要な属性や文脈を残すことです。たとえば氏名は「顧客A」、詳細住所は「東京都内」のように置き換えると実用性を残しやすくなります。

    ローカルLLMを使えば個人情報をそのまま扱えますか?

    ローカルLLMは外部送信の不安を下げる選択肢ですが、何を入れてもよいという意味ではありません。端末やサーバーのアクセス権限、ログ保存、RAG文書の範囲、バックアップの扱いを合わせて設計する必要があります。

    小規模事業者でもAI向けの個人情報対策は必要ですか?

    必要です。大きなセキュリティ体制を最初から作れなくても、AIに渡す情報を減らす、氏名や連絡先を置き換える、ログに残す情報を決める、といった小さな対策から始められます。

    AI業務自動化を相談する前に何を用意すればよいですか?

    AIに任せたい作業、現在使っているフォームやスプレッドシート、AIへ渡すのが不安な情報、最終的に人が確認したい工程を整理しておくと相談しやすくなります。完璧な仕様書は不要です。

  • 社内文書をAI検索する前にやること|RAGで失敗しない文書棚卸しの始め方

    社内文書をAI検索する前にやること|RAGで失敗しない文書棚卸しの始め方

    「社内のPDFや議事録をAIで検索できるようにしたい」
    「Google DriveやNotionの資料をRAGで社内チャット化したい」
    「ローカルLLMで安全にナレッジ検索を作れないか」

    こうした相談は増えています。社内文書をAIで検索できるようになると、過去の提案書、問い合わせ対応履歴、業務マニュアル、議事録、仕様書を探す時間を減らせます。新人への説明、営業資料の再利用、問い合わせ対応、社内FAQの整備にもつながります。

    ただし、いきなりRAGやAIチャットを作り始めると、思ったほど便利にならないことがあります。理由はモデルの性能だけではありません。AIに渡す前の文書が散らかっていると、検索結果も回答も散らかります。

    この記事では、社内文書をAI検索する前にやるべき文書棚卸し、権限整理、更新ルール、最初のPoC範囲の決め方を解説します。

    社内文書AI検索でよくある失敗

    社内文書AI検索の失敗は、技術選定より前の段階で起きていることが多いです。

    よくあるのは、次のような状態です。

    • 古い資料と最新資料が同じ場所にある
    • 同じ意味のファイルが複数存在する
    • ファイル名だけでは中身が分からない
    • 閲覧権限が部署や案件ごとに整理されていない
    • 議事録、チャット、PDF、スプレッドシートが別々に散らばっている
    • 正式なルールと個人メモが混ざっている
    • どの文書をAIに読ませてよいか判断できない

    この状態でRAGを組むと、AIは「社内文書を読んでいる」ように見えても、古い情報や関係ない情報を根拠に回答してしまいます。結果として、検索はできるが信用できない、便利そうだが業務では使いにくい、という状態になります。

    RAG導入前に最初に決めるべきこと

    最初に決めるべきなのは、どのAIを使うかではなく「何を探せるようにしたいか」です。

    例えば、社内文書検索といっても目的はさまざまです。

    • 営業が過去の提案書を探したい
    • CSが問い合わせ回答例を探したい
    • 経理や総務が社内手順を確認したい
    • 開発チームが仕様や議事録を横断検索したい
    • 経営者が過去の意思決定の背景を確認したい

    目的が違えば、集める文書も、必要な権限も、回答の粒度も変わります。

    最初から全社の情報を対象にする必要はありません。むしろ、最初は「問い合わせ対応のFAQだけ」「営業提案書の一部だけ」「社内マニュアルだけ」のように、範囲を狭くした方が成功しやすくなります。

    文書棚卸しで見るべき5つのポイント

    社内AI検索の準備では、文書をきれいに分類するだけでは不十分です。AIが検索しやすく、利用者が信頼しやすい状態にする必要があります。

    1. 最新版がどれか分かるか

    AI検索で最も危ないのは、古い資料をもっともらしく引用することです。

    まずは、同じテーマの文書が複数ある場合に、最新版がどれか分かる状態にします。ファイル名に日付や版数を入れる、古い資料をアーカイブに移す、正式版と作業中を分けるだけでも効果があります。

    「AIに聞けば分かる」状態を作る前に、「人間が見ても最新版が分かる」状態を作ることが重要です。

    2. AIに読ませてよい文書か

    社内文書には、AI検索に向いているものと向いていないものがあります。

    例えば、社内マニュアル、公開済み提案書、FAQ、業務手順書は比較的扱いやすい文書です。一方で、個人情報、未公開の契約条件、人事情報、顧客ごとの機密情報が含まれる文書は、慎重に扱う必要があります。

    クラウド型AIを使うのか、ローカルLLMや閉じた環境で処理するのかによっても設計は変わります。機密性の高い文書を扱う場合は、最初からローカル環境やアクセス制御を前提に検討した方がよい場合があります。

    3. 誰が見てよい情報か

    RAGやAIチャットでは、文書を検索できるだけでなく「その人が見てよい文書だけを検索する」設計が重要です。

    営業資料は全員が見てよいが、案件別の見積書は担当者だけ。社内マニュアルは全員が見てよいが、採用候補者の評価メモは一部だけ。こうした違いを整理しないままAI検索を作ると、情報漏えいのリスクが出ます。

    最初のPoCでは、権限が複雑な文書を避け、全員が見ても問題ない文書群から始めるのも現実的です。

    4. 文書の単位が細かすぎないか、大きすぎないか

    AI検索では、文書をどの単位で取り込むかも重要です。

    1つのPDFにすべての業務手順が詰まっていると、AIが必要な箇所を見つけにくくなります。逆に、細切れのメモが大量にあると、文脈が足りずに回答が不安定になります。

    マニュアルであれば章ごと、FAQであれば質問ごと、議事録であれば決定事項や論点ごとに整理されていると、RAGで扱いやすくなります。

    5. 更新ルールがあるか

    AI検索は、作って終わりではありません。元の文書が更新されなければ、AIの回答も古くなります。

    文書棚卸しの段階で、誰が更新するのか、どのタイミングでAI検索側に反映するのか、古い資料をどう扱うのかを決めておきます。

    小さな運用でも構いません。例えば「月1回、社内FAQだけ更新する」「問い合わせテンプレートだけ担当者が確認する」といった形でも、放置されるAI検索よりずっと実用的です。

    最初のPoCは小さく作る

    社内AI検索は、最初から大きく作るほど難しくなります。

    おすすめは、次のような小さな範囲から始めることです。

    • よく聞かれる社内FAQを30から50件だけAI検索化する
    • 特定部署の業務マニュアルだけを対象にする
    • 過去の提案書のうち、公開してよいテンプレートだけを取り込む
    • 問い合わせ回答例のうち、個人情報を含まないものだけを対象にする
    • 議事録から決定事項だけを抽出して検索対象にする

    この段階では、完璧なAIチャットを目指すよりも「本当に探す時間が減るか」「間違った回答が出たときに原因を追えるか」を確認します。

    もし小さな範囲で便利にならないなら、全社展開しても便利にはなりません。逆に、小さな範囲で効果が出れば、対象文書や機能を増やす判断がしやすくなります。

    ローカルLLMや社内環境が向いているケース

    社内文書検索では、クラウドAIだけでなく、ローカルLLMや閉じた環境でのRAG構築が候補になります。

    特に次のような場合は、ローカル環境や社内限定の構成を検討する価値があります。

    • 顧客情報や案件情報を含む文書を扱う
    • 外部サービスに文書を送れない
    • 社内ネットワーク内で完結させたい
    • 回答ログや参照元を自社で管理したい
    • 小規模でも専用の検索UIや管理画面が必要

    ただし、ローカルLLMにすれば自動的に安全になるわけではありません。文書の権限、ログの扱い、更新フロー、バックアップ、利用者ごとのアクセス制御は別途設計が必要です。

    重要なのは、AIモデル単体ではなく、文書、検索、権限、UI、運用をひとつの業務ツールとして考えることです。

    社内AI検索を業務に乗せるための画面設計

    社内AI検索は、チャット画面だけ作ればよいとは限りません。

    実務では、次のような画面や機能があると使いやすくなります。

    • 参照元文書を必ず表示する
    • 回答に自信がない場合は断る
    • 文書の更新日を表示する
    • よく使う質問をテンプレート化する
    • 回答結果を保存、共有できる
    • 間違った回答をフィードバックできる
    • 管理者が取り込み文書を確認できる

    特に重要なのは、参照元の表示です。AIの回答だけを見せると、利用者は正しいかどうか判断しにくくなります。どの文書のどの部分を根拠にしたのか分かるだけで、業務利用の安心感は大きく変わります。

    まず作るなら「文書棚卸しリスト」から

    AI検索の前に、まずは簡単な棚卸しリストを作るのがおすすめです。

    項目は複雑でなくて構いません。

    • 文書名
    • 保管場所
    • 内容の種類
    • 最新版かどうか
    • 閲覧してよい人
    • AI検索に入れてよいか
    • 更新担当者
    • 更新頻度
    • 注意点

    このリストを作るだけで、AI検索に向いている文書と、まだ整理が必要な文書が見えてきます。

    RAGやローカルLLMの構築は、この棚卸しがあるとかなり進めやすくなります。取り込む文書の優先順位、権限設計、PoC範囲、画面設計を具体的に決められるからです。

    YOSHIO.devで相談できること

    YOSHIO.devでは、社内文書をAI検索するための小さなRAG環境、ローカルLLM検証、社内AIチャット、文書整理を前提にした小型業務ツール開発を相談できます。

    例えば、次のような相談に対応できます。

    • 社内文書AI検索のPoC範囲を決めたい
    • RAGに入れる文書の整理方法を相談したい
    • ローカルLLMで社内資料を検索できるか試したい
    • Google Drive、Notion、PDFなどを横断検索する小型ツールを作りたい
    • 参照元付きの社内AIチャットを作りたい
    • AI検索に入れてよい文書、入れない文書を整理したい

    いきなり大規模なAI導入をするのではなく、まずは小さな文書群で「業務で使えるか」を確認する進め方が現実的です。

    関連サービス:

    社内文書をAI検索したいが、何から整理すべきか分からない方へ。

    RAG導入前の文書棚卸し、PoC範囲の決め方、ローカルLLMや小型検索ツールの構成まで、現在の資料状況に合わせて相談できます。

    YOSHIO.devに相談する

    FAQ

    社内文書をAI検索するには、最初に何をすればいいですか?

    まずは対象文書の棚卸しから始めるのがおすすめです。文書名、保管場所、最新版かどうか、閲覧権限、AI検索に入れてよいかを整理すると、RAGや社内AIチャットのPoC範囲を決めやすくなります。

    RAGを導入すれば、社内文書検索はすぐ便利になりますか?

    元の文書が整理されていないと、RAGを導入しても古い情報や関係ない情報をもとに回答することがあります。AIモデルの前に、文書の最新版管理、権限、更新ルールを整えることが重要です。

    ローカルLLMで社内文書を検索するメリットは何ですか?

    社内ネットワーク内で処理しやすいこと、機密文書を外部サービスに送らず検証しやすいこと、ログや参照元を自社で管理しやすいことがメリットです。ただし、権限設計や文書更新の運用は別途必要です。

    最初から全社の文書をAI検索化した方がよいですか?

    最初は範囲を絞る方が成功しやすいです。社内FAQ、特定部署のマニュアル、個人情報を含まない問い合わせ回答例など、小さな文書群で効果を確認してから広げるのが現実的です。

    社内AI検索ツールはどのくらい小さく始められますか?

    30から50件程度のFAQや、1部署の業務マニュアルだけを対象にしたPoCから始められます。参照元表示、簡単な検索画面、回答ログの確認など、必要最小限の機能に絞ると検証しやすくなります。

  • 社内AIチャットのログ設計|RAGを改善できる質問・回答履歴の残し方

    社内AIチャットのログ設計|RAGを改善できる質問・回答履歴の残し方

    社内AIチャットやRAGを導入すると、最初は「質問に答えられるか」に注目しがちです。しかし運用を始めると、別の問題が出てきます。

    「どんな質問が多いのか分からない」「間違った回答を後から確認できない」「どの資料を根拠に答えたのか追えない」「改善したつもりでも効果が分からない」といった状態です。

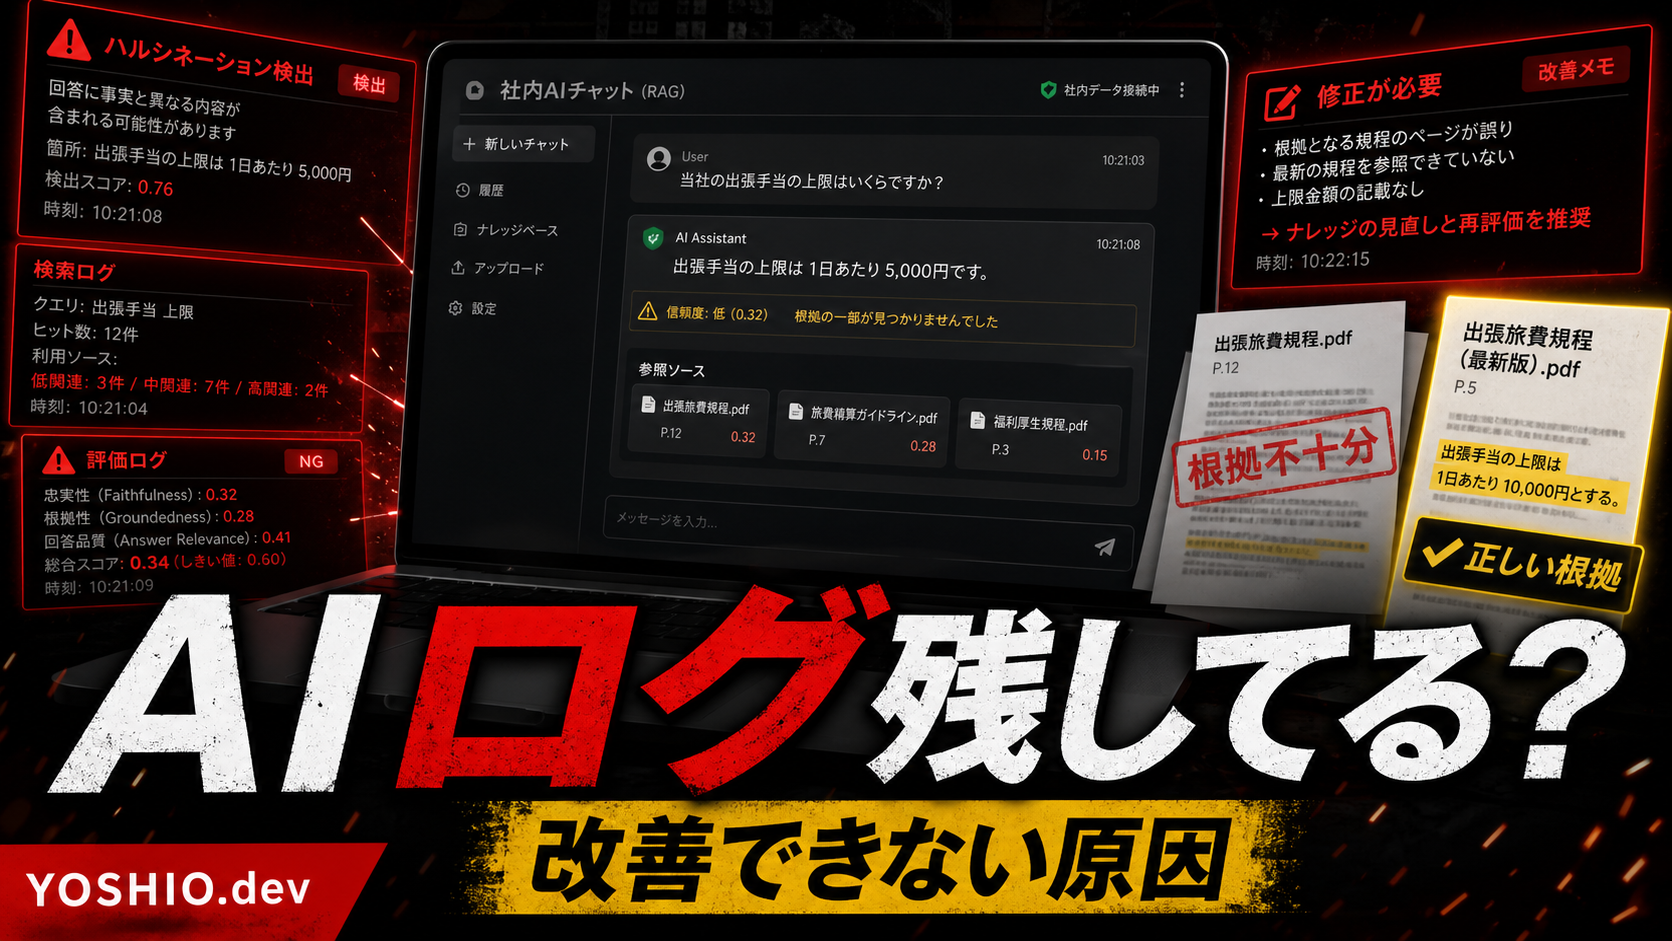
    この原因のひとつが、ログ設計の不足です。AIチャットのログは、単なる会話履歴ではありません。RAGを改善し、社内で安心して使うための点検記録になります。

    この記事では、小規模事業者や少人数チームが社内AIチャット・RAGを作るときに、最初から考えておきたいログ設計を整理します。

    社内AIチャットは「作って終わり」では精度が育たない

    RAGや社内AIチャットは、最初の構築だけで完成するものではありません。

    実際に使われ始めると、次のようなことが分かってきます。

    • 社員が想定と違う聞き方をしている
    • よく聞かれる質問に対応する資料がない
    • 古い資料を根拠に回答している
    • 検索結果は合っているのに回答文が弱い
    • 部署ごとに使いたい情報が違う
    • 本当はAIに聞かず、別の画面で確認した方がよい質問がある

    これらは、実際の質問と回答を見ないと分かりません。ログが残っていないと、「なんとなく使いにくい」「精度が悪い気がする」という感想だけが残り、改善箇所を特定できなくなります。

    ログを残す目的を先に決める

    ログ設計では、何でも保存すればよいわけではありません。まず、何のためにログを使うかを決めます。

    目的は大きく分けて次の4つです。

    • 回答精度を改善する
    • よくある質問を見つける
    • 間違った回答を確認する
    • 個人情報や機密情報の扱いを点検する

    たとえば、回答精度を改善したいなら、質問、回答、参照元、期待した回答を残す必要があります。よくある質問を見つけたいなら、質問カテゴリや利用部署が重要になります。

    目的が決まっていないままログを増やすと、後から見返しても使いにくい履歴になります。

    最低限残したいログ項目

    小さく始めるなら、最初から複雑な管理画面は不要です。まずは次の項目を残せる状態にします。

    • 質問日時
    • 質問文
    • AIの回答
    • 参照した資料名やURL
    • 回答できたか、できなかったか
    • 利用者または部署の区分
    • 人間が修正した内容
    • 改善メモ

    この程度でも、あとから「どの質問で失敗しているか」「どの資料がよく使われているか」「どの回答を直すべきか」が見えやすくなります。

    最初はスプレッドシートや簡単な管理画面でも構いません。重要なのは、改善に使える形で同じ項目を残し続けることです。

    質問文だけでは改善に使いにくい

    ログというと、質問文だけを保存すればよいと思われがちです。しかし、質問文だけではRAGの改善には不十分です。

    たとえば、次のような質問が残っていたとします。

    「解約時の対応を教えて」

    この質問だけでは、AIが正しく答えたのか、どの資料を参照したのか、社内ルールと合っていたのかが分かりません。

    改善に使うには、少なくとも次の情報が必要です。

    • AIが返した回答
    • 検索で拾った資料
    • 本来参照すべきだった資料
    • 回答に不足していた情報
    • その質問が社内向けか顧客対応向けか

    RAGの改善では、「質問されたこと」よりも、「その質問にどう答え、どの根拠を使ったか」が重要です。

    参照元の記録は信頼性に直結する

    社内AIチャットで特に残したいのが、参照元の記録です。

    AIが正しそうな文章を返していても、根拠が分からなければ業務では使いにくくなります。逆に、回答が少し不完全でも、参照元が分かれば人間が確認できます。

    参照元ログでは、次のような情報を残します。

    • 参照したファイル名
    • 資料の更新日
    • 該当ページや見出し
    • 検索スコアや取得順位
    • 古い資料を参照していないか

    特に料金、契約、手順、顧客対応に関わる回答では、どの資料を根拠にしたかを追えることが重要です。

    個人情報と機密情報は保存範囲を絞る

    ログを残すときに注意したいのが、個人情報や機密情報です。

    社内AIチャットでは、利用者が顧客名、メールアドレス、案件名、契約内容、社内メモなどを入力することがあります。そのまま長期間保存すると、ログ自体が管理対象になります。

    最初に決めたいのは次の点です。

    • 個人名やメールアドレスを保存する必要があるか
    • 保存前に一部を伏せ字にするか
    • ログを誰が閲覧できるか
    • 保存期間を何日、何か月にするか
    • 削除依頼があった場合に対応できるか
    • クラウドに保存するか、ローカル環境に残すか

    小規模な運用でも、ログの扱いを決めておかないと、あとから「便利だが見せられない履歴」が増えてしまいます。

    ログから改善タスクを作る

    ログは保存するだけでは意味がありません。定期的に見返して、改善タスクに変える必要があります。

    たとえば、週に1回だけでも次のように確認します。

    • 回答できなかった質問を3件見る
    • 古い資料を参照した回答を確認する
    • よく出る質問をFAQ候補にする
    • 資料不足のテーマを洗い出す
    • プロンプトや回答ルールの修正点をメモする
    • 検索対象から外す資料を決める

    この作業を続けると、社内AIチャットは単なる検索窓ではなく、社内ナレッジの弱い場所を見つける仕組みになります。

    小さく始めるログ設計チェックリスト

    最初から大きな監査システムを作る必要はありません。まずは次の項目を決めるだけでも、改善しやすくなります。

    • ログを何のために使うか
    • 質問と回答をどこまで保存するか
    • 参照元を記録できるか
    • 個人情報を伏せるルールがあるか
    • ログを見られる人を決めているか
    • 保存期間を決めているか
    • 回答の良し悪しを評価する欄があるか
    • 改善メモを残す欄があるか
    • 定期的に見返す担当者やタイミングがあるか

    このチェックリストをもとに、まずはスプレッドシート、簡易データベース、小さな管理画面のどれで始めるかを決めると現実的です。

    YOSHIO.devで相談できること

    YOSHIO.devでは、ローカルLLM・RAG環境構築、社内AIチャットの試作、参照元表示、ログ設計、少人数チーム向けの改善フロー作りについて相談できます。

    また、ログをスプレッドシートや小さな管理画面に残す仕組みは、業務自動化や小型ツール開発とも相性があります。

    「社内AIチャットを作ったが改善方法が分からない」「RAGの回答を後から確認できるようにしたい」「クラウドに出したくない情報がある」といった段階でも、小さな範囲から相談できます。

    FAQ

    社内AIチャットのログは必ず保存した方がよいですか?

    改善やトラブル確認に使うなら、最低限のログは残した方がよいです。ただし、個人情報や機密情報をそのまま長期間保存する必要があるとは限りません。目的に合わせて保存項目と保存期間を決めることが大切です。

    ログ管理はスプレッドシートでも始められますか?

    小さく試す段階なら、スプレッドシートでも始められます。質問、回答、参照元、評価、改善メモを残せるだけでも、よくある失敗や資料不足を見つけやすくなります。利用が増えたら管理画面やデータベース化を検討します。

    ローカルLLMならログに個人情報を残しても安全ですか?

    ローカル環境でも、ログを誰が見られるか、どこに保存するか、いつ削除するかは別途決める必要があります。外部送信しないことと、社内で安全に管理できることは同じではありません。

  • RAGの回答精度が低い時に見るべき原因|社内AIチャットを作り直す前の診断チェック

    RAGの回答精度が低い時に見るべき原因|社内AIチャットを作り直す前の診断チェック

    RAGや社内AIチャットを導入したあと、「思ったより答えが合わない」「資料は入れたのに古い回答が出る」「根拠が曖昧で信用できない」と感じることがあります。

    この状態になると、すぐに「もっと高性能なAIモデルに変えるべきか」「一から作り直すべきか」と考えがちです。

    しかし、RAGの回答精度が低い原因は、AIモデルだけとは限りません。実際には、資料の状態、検索方法、分割の仕方、プロンプト、権限、更新ルール、質問の想定がずれていることも多くあります。

    この記事では、小規模事業者や少人数チームがRAG・社内AIチャットの精度に不満を感じた時、作り直す前に確認したい原因切り分けの手順を整理します。

    RAGの精度問題は「AIが賢くない」だけではない

    RAGは、社内資料やFAQ、マニュアル、過去対応履歴などを検索し、その検索結果をもとにAIが回答する仕組みです。

    そのため、回答が外れる時は、大きく分けて次のどこかで問題が起きています。

    • そもそも必要な資料が入っていない
    • 古い資料や重複資料が混ざっている
    • 検索で正しい資料が拾えていない
    • 拾った資料をAIがうまく使えていない
    • 質問の形式と資料の書き方が合っていない
    • 回答後の確認・修正ルールがない

    つまり、AIモデルだけを変えても、資料や検索の問題が残っていれば改善しない場合があります。

    まずは、回答が悪い原因を「資料」「検索」「生成」「運用」に分けて見ます。

    原因1: 必要な資料が検索対象に入っていない

    最初に確認したいのは、AIが参照できる資料の範囲です。

    人間が知っている情報でも、RAGの検索対象に入っていなければAIは答えられません。たとえば、最新の料金表は担当者のPCにあり、RAGには古いPDFだけが入っている、という状態では正しい回答は出ません。

    次のような状態がないか確認します。

    • 最新版の資料が対象フォルダに入っていない
    • 口頭やチャットだけで共有されているルールがある
    • よく聞かれる質問に対応する資料が存在しない
    • 営業資料、FAQ、マニュアルが別々に管理されている
    • 過去の対応履歴をAIが参照できない

    回答精度を上げる前に、「この質問に答えるための資料は本当に入っているか」を確認する必要があります。

    原因2: 古い資料と新しい資料が混ざっている

    RAGでよく起きる問題が、古い資料と新しい資料の混在です。

    たとえば、料金改定前のPDF、旧サービス説明、過去のキャンペーン資料、古いマニュアルが残っていると、AIが古い内容を根拠に回答することがあります。

    特に危ないのは、ファイル名だけでは新旧が分からない状態です。

    • 資料_final.pdf
    • 資料_最新版.pdf
    • サービス説明_修正版.pdf
    • マニュアル_新.pdf

    このような名前が並んでいると、人間でも判断が難しくなります。

    改善するには、資料ごとに更新日、対象サービス、利用可否を分かる形にします。古い資料を削除できない場合でも、「参照禁止」「過去資料」「2025年以前」などの扱いを決めておくと、誤回答を減らしやすくなります。

    原因3: 資料の分割単位が大きすぎる、または細かすぎる

    RAGでは、資料を一定の単位に分けて検索することがあります。この分け方が合っていないと、必要な情報が拾えなかったり、文脈が途切れたりします。

    分割が大きすぎる場合、検索結果に余計な情報が多く入り、AIがどこを使えばよいか迷います。

    逆に分割が細かすぎる場合、重要な前後関係が失われます。たとえば、料金表の注意書きだけが切り離されると、「どのプランに関する注意か」が分からなくなります。

    確認したいポイントは次の通りです。

    • 1つの検索結果に複数テーマが混ざっていないか
    • 表の見出しと中身が切り離されていないか
    • 手順の前後関係が崩れていないか
    • FAQの質問と回答が別々に分かれていないか
    • 短すぎる断片だけが大量に検索されていないか

    社内AIチャットでよく使う資料は、検索しやすい形に整えるだけで回答が改善することがあります。

    原因4: 質問文と資料内の言葉がずれている

    社員やスタッフが使う言葉と、資料に書かれている言葉が違う場合も、検索が外れやすくなります。

    たとえば、社内では「キャンセル対応」と呼んでいるのに、マニュアルでは「解約手続き」と書かれている。現場では「請求ミス」と言うのに、資料では「請求額差異」と書かれている。このような言葉のずれがあると、検索で正しい資料が見つかりにくくなります。

    改善するには、よく使われる言い換えを整理します。

    • 社内で使う略語
    • お客様が問い合わせで使う表現
    • 正式名称と通称
    • 旧サービス名と新サービス名
    • よくある誤記や表記ゆれ

    RAGの精度改善では、AI側だけでなく、資料側に検索されやすい見出しや言い換えを足すことも有効です。

    原因5: プロンプトで回答ルールが弱い

    検索で正しい資料が拾えていても、AIがその資料をどう使うかのルールが弱いと、回答が曖昧になります。

    たとえば、次のような問題です。

    • 根拠がない時でも推測で答えてしまう
    • 複数資料が矛盾している時に古い情報を選んでしまう
    • 回答に参照元を出さない
    • 分からない場合に確認先を示さない
    • 社外向け・社内向けの言い方が混ざる

    この場合は、「必ず資料に基づいて答える」「根拠が見つからない場合は分からないと返す」「日付が新しい資料を優先する」「参照元を表示する」など、回答ルールを明確にします。

    ただし、プロンプトだけで全てを解決しようとしないことも重要です。古い資料が残っている、権限が曖昧、検索対象が広すぎるといった問題は、運用や設計側で直す必要があります。

    原因6: 正解例と失敗例を残していない

    RAGの改善では、「なんとなく精度が悪い」という感想だけでは原因を特定しにくくなります。

    改善しやすくするには、実際の質問と回答を残します。

    • ユーザーが入力した質問
    • AIの回答
    • 本来期待していた回答
    • 参照すべきだった資料
    • 問題の種類

    問題の種類は、たとえば「資料不足」「古い資料を参照」「検索失敗」「回答ルール不足」「質問が曖昧」などに分けます。

    この記録があると、AIモデルを変えるべきなのか、資料を直すべきなのか、検索設定を見直すべきなのか判断しやすくなります。

    まず試したい診断チェックリスト

    RAGや社内AIチャットの回答精度が低い時は、次の順番で確認します。

    1. よく外れる質問を5件集める
    2. それぞれに正解資料が存在するか確認する
    3. 正解資料が検索対象に入っているか確認する
    4. 古い資料や重複資料が混ざっていないか確認する
    5. 検索結果に正しい資料が出ているか確認する
    6. AIが検索結果を正しく使っているか確認する
    7. 回答できない時のルールがあるか確認する
    8. 改善後に同じ質問で再テストする

    この順番にすると、いきなり大きな改修に進まず、原因を小さく分けて確認できます。

    作り直す前に相談するとよい状態

    RAGの改善を相談する時は、完璧な仕様書よりも、失敗例がある方が話が早くなります。

    たとえば、次の情報があると原因を切り分けやすくなります。

    • 期待と違った質問例
    • 実際に返ってきた回答
    • 本当は参照してほしかった資料
    • 資料の保存場所やフォルダ構成
    • 古い資料を残す必要があるか
    • 誰が使うAIチャットなのか
    • 社外に出せない情報が含まれるか

    「回答精度を上げたい」という相談でも、原因が資料側にあるのか、検索側にあるのか、AIの回答ルールにあるのかで対応は変わります。

    YOSHIO.devでは、ローカルLLM・RAG環境構築、社内資料のAI検索、少人数チーム向けの業務自動化について相談できます。すでに試作したRAGや社内AIチャットがある場合も、作り直し前の診断から相談できます。

    まとめ

    RAGの回答精度が低い時、すぐにAIモデルを変えたり、全体を作り直したりする必要があるとは限りません。

    まずは、必要な資料が入っているか、古い資料が混ざっていないか、検索で正しい資料が拾えているか、AIが根拠に基づいて回答しているかを分けて確認します。

    原因を切り分けることで、小さな修正で改善できる部分と、設計から見直すべき部分が見えやすくなります。

    FAQ

    RAGの回答精度が低い場合、AIモデルを変えれば改善しますか?

    改善する場合もありますが、最初に資料、検索対象、古い情報の混在、回答ルールを確認するのがおすすめです。必要な資料が入っていない、検索で拾えていない、古い資料を参照している状態では、AIモデルだけを変えても根本的に改善しないことがあります。

    社内AIチャットが間違った回答をする時、何から記録すればよいですか?

    実際の質問、AIの回答、本来期待していた回答、参照すべきだった資料を残します。さらに、問題が資料不足なのか、検索失敗なのか、古い資料の参照なのかを分類すると、改善箇所を判断しやすくなります。

    古い資料を削除できない場合、RAGではどう扱えばよいですか?

    削除できない資料は、参照禁止、過去資料、旧版などの扱いを明確にする必要があります。ファイル名やメタ情報で更新日と利用可否を分け、AIが最新資料を優先できるようにします。

    小規模事業者でもRAGの精度改善は相談できますか?

    相談できます。大規模な再構築ではなく、よく外れる質問を数件集めて、資料、検索、回答ルール、運用のどこに原因があるかを切り分けるところから始められます。

  • ローカルLLM・RAGの質問履歴は残すべき?小規模導入で決めるログ管理ルール

    ローカルLLM・RAGの質問履歴は残すべき?小規模導入で決めるログ管理ルール

    ローカルLLMやRAGを試すとき、多くの人が最初に気にするのは「クラウドに情報を送らずに使えるか」です。たしかに、手元のPCや社内環境で動かせることは大きな安心材料です。

    ただし、ローカルで動くからといって、何も決めずに安全になるわけではありません。特に見落とされやすいのが、質問履歴やログの扱いです。

    誰が、いつ、どんな質問をしたのか。AIがどの資料を参照したのか。回答に機密情報が含まれていなかったか。こうした履歴を残すべきか、残すならどこまで残すかを決めないまま運用を始めると、あとから不安が大きくなります。

    ローカルLLMでも「履歴が残らない」とは限らない

    ローカルLLMは、ChatGPTなどのクラウドAIとは違い、モデルを手元のPCやサーバーで動かせます。そのため、入力内容を外部サービスへ送らずに試せる場合があります。

    しかし、実際の環境では次のような場所に履歴が残ることがあります。

    • チャットUIの会話履歴
    • アプリケーションのログファイル
    • RAGの検索ログ
    • 参照された文書名やスコア
    • ブラウザやツール側の一時保存データ
    • エラー発生時のデバッグログ

    つまり、「ローカルだから履歴は残らない」と考えるのではなく、「どこに何が残る設計なのか」を確認することが重要です。

    ログを残すメリットもある

    質問履歴やログは、危ないものとして全部消せばよいわけではありません。運用改善には役立ちます。

    たとえば、次のような確認ができます。

    • よく聞かれる質問は何か
    • 回答できなかった質問はどれか
    • 参照資料が古くなっていないか
    • 期待と違う回答が出ていないか
    • 社内で実際に使われているか

    ログがまったくないと、RAGの精度改善や資料整備が難しくなります。小規模導入では、最初から完璧なAIを作るより、実際の質問を見ながら改善する方が現実的です。

    一方で、質問内容そのものは機密になりやすい

    注意したいのは、質問履歴には利用者の関心や業務内容がそのまま出ることです。

    たとえば、次のような質問は履歴として残るだけでも慎重に扱う必要があります。

    • 特定顧客の契約条件を確認する質問
    • 未公開サービスや価格に関する質問
    • 社内の人事・評価に関する質問
    • トラブル対応やクレーム対応に関する質問
    • 個人情報を含む問い合わせ文の貼り付け

    AIの回答そのものだけでなく、「何を聞いたか」も情報です。ログ管理では、回答内容だけでなく質問文も保護対象として考える必要があります。

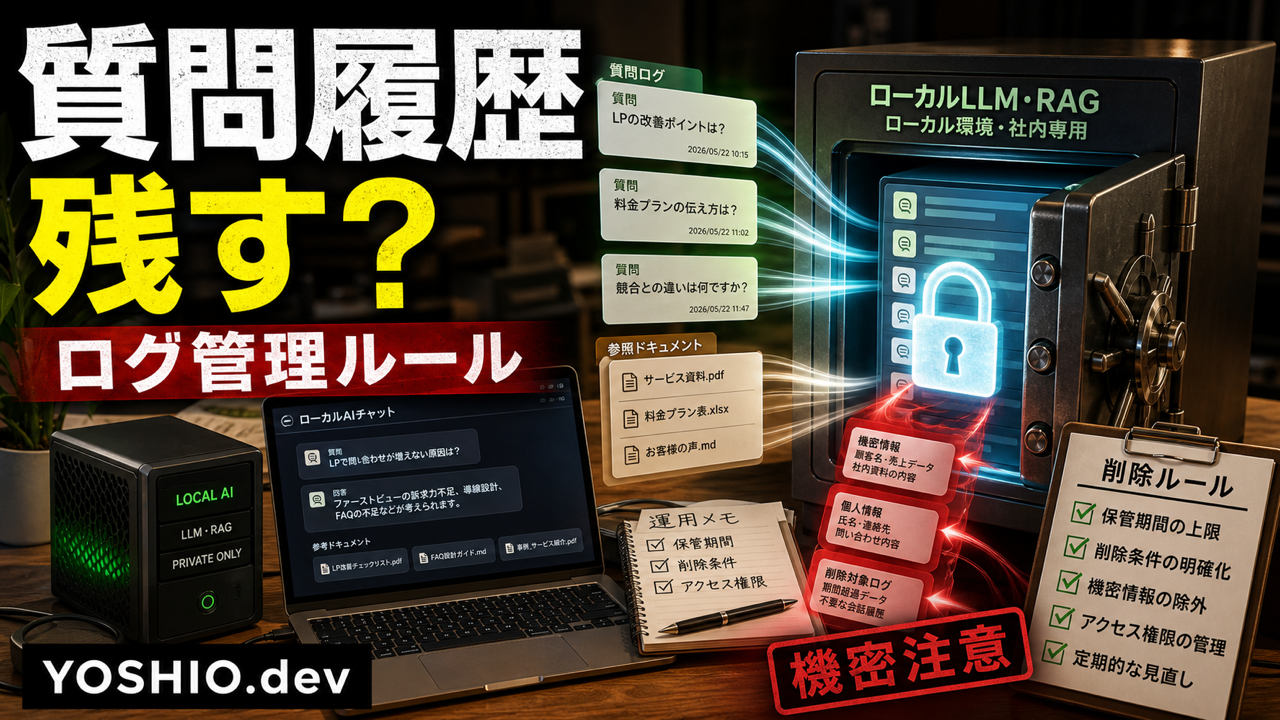
    最初に決めたいログ管理ルール

    小規模なローカルLLM・RAG環境では、最初から大きな監査システムを作る必要はありません。まずは次の項目だけでも決めておくと、運用しやすくなります。

    • 質問履歴を保存するか
    • 保存する場合、誰が見られるか
    • 保存期間を何日にするか
    • 個人情報や顧客名を含む質問をどう扱うか
    • 削除依頼があったときの対応方法
    • 改善用に使うログと、残さないログを分けるか

    おすすめは、最初からすべてを長期保存しないことです。検証段階では短期間だけ保存し、改善に必要な項目だけを見る運用の方が安心です。

    RAGでは「どの資料を参照したか」もログになる

    RAG環境では、質問文と回答文だけでなく、AIがどの資料を参照したかも重要です。

    たとえば、AIが古い料金表を参照していた場合、回答内容だけを見ても原因が分かりにくいことがあります。参照元の文書名や更新日が分かれば、資料側を直せます。

    一方で、参照ログには「その人がどの顧客資料にアクセスしたか」という情報が含まれる場合もあります。アクセス権限とログ閲覧権限を分けて考える必要があります。

    ログに残さない方がよい情報

    改善のためにログは便利ですが、何でも残すのは危険です。特に次の情報は、残さない、伏せる、短期間で削除するなどの対応を検討します。

    • 氏名、住所、電話番号、メールアドレス
    • 顧客名や案件名
    • 認証情報、APIキー、パスワード
    • 未公開の見積金額や契約条件
    • 社内評価や個別トラブルの詳細

    ログを改善に使う場合も、個人名や顧客名を置き換える、質問文を要約して保存する、参照文書名だけ残すなどの工夫ができます。

    小さく始めるなら「短期保存+手動確認」でよい

    小規模事業者や個人事業の段階では、最初から複雑なログ基盤を作るより、シンプルなルールで始める方が続きます。

    たとえば、次のような形です。

    • 検証中の質問履歴は7日から30日だけ保存
    • ログを見られる人は管理者に限定
    • 個人情報を含む質問は禁止ルールとして明記
    • 改善に使う場合は質問を要約して残す
    • 本番運用前にログ保存範囲を見直す

    最初の目的は、完璧な監査ではなく、安心して試せる状態を作ることです。

    相談前に整理しておくとよいこと

    ローカルLLMやRAG環境の相談をする前に、次の情報を整理しておくと設計が進めやすくなります。

    • 誰がAIチャットを使うのか
    • どんな資料を参照させたいのか
    • 質問履歴を残したい目的は何か
    • 残したくない情報は何か
    • 管理者が確認したい項目は何か
    • 保存期間の希望はあるか

    ここまで決めておくと、ローカルLLMが向いているのか、クラウドAIと併用する方がよいのか、RAGをどこまで作るべきか判断しやすくなります。

    まとめ

    ローカルLLMやRAGは、情報を外部に出しにくい形でAIを試せる選択肢です。ただし、質問履歴やログの扱いを決めないまま始めると、あとから不安や運用負担が出ます。

    導入前には、ログを残す目的、保存期間、閲覧権限、削除ルール、残してはいけない情報を整理しておくことが大切です。

    YOSHIO.devでは、ローカルLLM・RAG環境の小規模導入、社内AIチャットの試作、資料整理、ログ運用ルールの設計まで、目的に合わせて相談できます。

    ローカルLLMやRAGを試したいけれど、質問履歴、ログ、機密情報の扱いが不安な場合は、導入前の設計からご相談いただけます。現在の資料、使いたい範囲、残したくない情報をもとに、小さく安全に試せる構成を整理します。

    よくある質問

    ローカルLLMなら質問履歴は外部に送られませんか?

    環境構成によります。モデル自体はローカルで動いていても、UI、拡張機能、連携ツール、ログ保存先によって扱いが変わります。導入前に通信先と保存先を確認することが重要です。

    質問履歴は残した方がよいですか?

    改善目的なら短期間だけ残すのは有効です。ただし、個人情報や顧客情報が含まれる可能性があるため、保存期間と閲覧権限を決めておく必要があります。

    RAGのログでは何を確認すべきですか?

    質問文、回答結果、参照された資料、回答できなかった質問、古い資料を参照していないかを確認すると改善に役立ちます。

    小規模導入でもログ管理は必要ですか?

    必要です。大きな監査システムまでは不要でも、質問履歴を残すか、誰が見られるか、いつ消すかは最初に決めておく方が安全です。

  • 社内AIチャットに根拠表示が必要な理由|RAGを信用して使うための設計

    社内AIチャットに根拠表示が必要な理由|RAGを信用して使うための設計

    社内AIチャットや文書検索AIを作るとき、最初は「質問に答えられるか」に注目しがちです。しかし実際の業務で使う段階になると、答えそのものだけでなく「その回答はどの資料をもとにしているのか」が重要になります。

    特にRAGを使って社内文書を参照させる場合、回答の根拠が見えないと、利用者は結局もとの資料を探し直すことになります。これではAIチャットを導入しても、確認作業があまり減りません。

    この記事では、小規模事業者や個人事業の現場で社内AIチャットを使うときに考えたい、根拠表示、参照元リンク、回答できない場面の設計について整理します。

    回答だけでは業務で使いにくい

    AIが自然な文章で答えてくれると、一見便利に見えます。しかし業務で使う場合は、自然な文章であるほど危険な面もあります。間違っていても、それらしく見えるからです。

    たとえば、社内マニュアル、料金表、契約前の説明資料、過去の議事録を対象にしたAIチャットでは、次のような不安が出やすくなります。

    • どの資料を見て答えたのか分からない
    • 古い資料をもとにしていないか不安
    • 回答に含まれる数字や条件を確認できない
    • AIが推測で補っているのか、資料に書いてあるのか分からない
    • 社外向けにそのまま使ってよい回答か判断できない

    RAGは社内資料を参照しやすくする仕組みですが、回答文だけを表示すると、利用者は根拠を確認できません。実務で使うなら、回答と一緒に参照元を見せる設計が必要です。

    根拠表示で最低限出したい情報

    根拠表示といっても、最初から大きな管理画面を作る必要はありません。まずは、利用者が「どこを確認すればよいか」分かる状態を目指します。

    表示項目目的
    ファイル名どの資料を参照したか分かる
    該当ページ・見出し確認場所を絞れる
    抜粋テキスト回答と資料のつながりを見られる
    更新日・版古い資料かどうか判断できる
    参照元リンク元資料をすぐ開ける

    特に重要なのは、ファイル名と抜粋です。回答の下に「参照元: 料金表_2026.pdf」「該当箇所: 保守対応の範囲」のように出るだけでも、利用者の安心感は変わります。

    「分からない」と答えられる設計にする

    社内AIチャットでありがちな失敗は、どんな質問にも無理に答えようとすることです。対象資料に書かれていない内容まで推測で答えると、業務では使いにくくなります。

    • 根拠資料が見つからない場合は「資料内では確認できません」と返す
    • 参照元が弱い場合は、断定せず確認を促す
    • 複数資料で内容が食い違う場合は、差分を示す
    • 社外向け文章や契約判断は、人の確認を前提にする
    • 古い資料を参照した場合は、更新日の確認を促す

    AIにすべて答えさせるより、「確認すべき場所をすばやく出す」役割にした方が、現場では使いやすくなります。

    参照元の出し方は業務に合わせる

    根拠表示の形は、使う人や業務によって変わります。自分だけが使う文書検索なら、簡単なファイル名表示で十分なこともあります。一方で、スタッフが複数人で使うなら、参照元リンクや更新日まで見える方が安心です。

    段階内容向いているケース
    簡易版回答とファイル名だけ表示個人利用、検証段階
    実用版抜粋、見出し、リンクを表示社内FAQ、マニュアル検索
    管理版更新日、版、確認ステータスも表示複数人利用、重要文書

    最初から完璧な仕組みにする必要はありません。まずはよく使う資料だけを対象にして、回答と参照元がセットで出る小さな画面を作る方が現実的です。

    RAGの精度は文書整理にも左右される

    根拠表示を作っても、資料側が整理されていないと使いにくくなります。ファイル名が分かりにくい、古い版が混ざっている、同じ内容の資料が複数ある、画像化PDFばかりで文字抽出できないといった状態では、AIの回答も不安定になります。

    • 最新版の資料が分かるか
    • 古い資料を除外できるか
    • ファイル名やフォルダ構成が業務名と対応しているか
    • PDFから文字を取り出せるか
    • 参照させてはいけない資料が混ざっていないか

    社内AIチャットは、AIモデルだけで決まるものではありません。文書整理、検索設計、画面表示、確認フローを合わせて考える必要があります。

    YOSHIO.devで相談できること

    YOSHIO.devでは、ローカルLLM・RAG環境構築、社内文書検索AI、小型業務ツール開発、業務自動化を組み合わせた相談に対応しています。

    • 社内資料を検索できるAIチャットを小さく試したい
    • RAGの回答に参照元や抜粋を表示したい
    • ローカルLLMで社内文書を扱えるか検証したい
    • PDFやWord資料を整理して検索しやすくしたい
    • AI回答をそのまま使わず、人が確認する画面を作りたい

    大きな社内システムを前提にしなくても、まずは対象資料を絞った検証環境から始められます。回答の正しさだけでなく、現場で確認しやすい形まで含めて設計することが大切です。

    まとめ

    社内AIチャットやRAGは、回答できるだけでは実務に定着しません。利用者が安心して使うには、どの資料をもとにした回答なのか、どこを確認すればよいのかが見える必要があります。

    最初は、回答、ファイル名、抜粋、参照元リンクを表示する小さな仕組みからで十分です。AIに判断を丸投げするのではなく、確認作業を短くする道具として設計すると、業務に取り入れやすくなります。

    よくある質問

    RAGを使えば、必ず正しい回答になりますか?

    必ず正しくなるわけではありません。RAGは資料を参照しやすくする仕組みですが、文書の状態、検索設計、回答の作り方によって精度が変わります。根拠表示や人の確認フローを入れることが重要です。

    回答に参照元を表示することはできますか?

    できます。ファイル名、抜粋、ページ番号、元資料へのリンクなどを回答と一緒に表示する設計が考えられます。最初は簡易的な表示から始めることも可能です。

    ローカルLLMでも根拠表示はできますか?

    構成によりますが、ローカルLLMとRAGを組み合わせて、参照した文書の情報を表示することは可能です。ただし、速度や検索精度、PCスペックの確認が必要です。

    すでに社内資料が整理されていなくても相談できますか?

    相談できます。ただし、古い資料や重複資料が多い場合は、AI環境を作る前に資料整理や対象範囲の絞り込みから始める方がうまく進みます。

  • RAG導入前にやるべき社内資料整理|AIが答えられない会社の共通点

    RAG導入前にやるべき社内資料整理|AIが答えられない会社の共通点

    RAGを入れれば、社内資料をAIが読んで答えてくれる。そう聞くと、すぐにチャット画面や検索システムを作りたくなります。

    しかし実際には、RAGの精度は「AIの賢さ」だけで決まりません。AIに渡す社内資料が古い、重複している、部署ごとに言い方が違う、権限が整理されていない。こうした状態のままRAGを作ると、AIはもっともらしく間違えます。

    この記事では、RAGやローカルLLM環境を導入する前に整理しておきたい社内資料のポイントを解説します。

    RAG導入で失敗しやすい会社の共通点

    RAGの失敗は、モデル選びよりも資料側で起きることが多いです。

    たとえば、次のような状態です。

    • 最新版と旧版のマニュアルが同じフォルダにある
    • PDF、Google Docs、Notion、Excelに同じ情報が分散している
    • ファイル名だけでは中身や更新日がわからない
    • 部署ごとに用語が違い、AIが同じ意味だと判断できない
    • 誰が見てよい資料か決まっていない
    • 退職者や前任者しか知らない資料が残っている

    この状態でRAGを構築すると、AIは「検索できた資料」を根拠に回答します。つまり、古い資料が引っかかれば古い回答をしますし、重複資料が多ければ回答が揺れます。

    まず整理すべき資料の種類

    最初から全社の資料をAI化しようとすると失敗しやすくなります。まずは、問い合わせや確認作業が多い領域に絞るのが現実的です。

    優先度が高いのは、次のような資料です。

    • よく聞かれる業務手順書
    • 営業資料、料金表、提案テンプレート
    • FAQ、問い合わせ対応履歴
    • 社内ルール、申請フロー、権限ルール
    • 商品・サービス仕様書
    • 過去の議事録や決定事項

    特に「人に聞かないとわからない」「毎回Slackやメールで同じ質問が出る」情報は、RAG化の効果が出やすい領域です。

    RAG導入前の資料整理チェック

    RAG用の資料は、ただ集めるだけでは不十分です。最低限、次の観点で整理しておく必要があります。

    1. 最新版を決める

    同じ内容の資料が複数ある場合、AIはどれが正しいか判断できません。まずは「正式な最新版」を決め、旧版にはアーカイブ、廃止、参考用などの状態を付けます。

    2. ファイル名と見出しを整える

    AI検索では、本文だけでなくタイトルや見出しも重要です。資料_final_最新_修正版.pdf のような名前ではなく、内容・対象・更新日がわかる命名にします。

    例: 営業提案_料金プラン_法人向け_2026-05.pdf

    3. 権限を分ける

    RAGでは、見せてはいけない資料をAIが参照しない設計が必要です。人事、契約、顧客情報、未公開情報などは、最初から権限単位を分けておくべきです。

    4. 用語を統一する

    「顧客」「クライアント」「取引先」が同じ意味で使われている場合、AI検索の精度が落ちることがあります。社内用語集を作るだけでも、回答の安定性は上がります。

    5. 更新責任者を決める

    RAGは作って終わりではありません。資料が古くなれば、AIの回答も古くなります。部署ごとに更新責任者を決め、月1回でも見直す運用が必要です。

    小さく始めるなら「1業務・30資料」から

    RAG導入は、最初から大規模に作る必要はありません。むしろ、最初は1つの業務に絞ったほうが成功しやすいです。

    • 営業担当向けの提案資料検索
    • 社内問い合わせFAQ
    • 制作・開発の引き継ぎ資料検索
    • 顧客対応マニュアル検索

    30から50資料程度でも、検索対象が整理されていれば十分に効果を検証できます。この段階で「AIがどの資料を根拠に答えたか」「回答が業務で使えるか」を確認し、範囲を広げていくのが安全です。

    YOSHIO.devで支援できること

    YOSHIO.devでは、RAGやローカルLLM環境をいきなり作るだけでなく、その前段階の資料整理や業務フロー確認から相談できます。

    • 社内資料の棚卸しとRAG化しやすい分類設計
    • ローカルLLM・RAG環境の小規模PoC構築
    • 社内FAQボット、検索ツール、小型業務ツールの開発
    • 業務自動化や更新チェックの仕組み化
    • LP制作や問い合わせ導線とAI活用の接続

    「AIを入れたいが、社内資料が散らかっている」という状態でも、最初の整理から始められます。

    FAQ

    Q. 社内資料が整理されていないとRAGは使えませんか?

    A. 使うことはできますが、回答精度が安定しにくくなります。特に旧資料や重複資料が多い場合、AIが誤った根拠を拾う可能性があります。

    Q. まず何から始めればよいですか?

    A. 問い合わせが多い業務を1つ選び、その業務で使う資料だけを集めるのがおすすめです。全社資料を一気に整理する必要はありません。

    Q. ローカルLLMとクラウドAIのどちらがよいですか?

    A. 扱う情報の機密性、予算、速度、運用体制によります。顧客情報や社内機密を扱う場合は、ローカル環境や権限設計を含めて検討する必要があります。

    Q. PDFやExcelもRAGに使えますか?

    A. 使えます。ただし、表の構造やスキャンPDFの品質によっては前処理が必要です。AIが読みやすい形式に変換する工程が重要です。

  • 社内RAGは「AI導入」より先にファイル整理で決まる。失敗しない準備チェックリスト

    社内RAGは「AI導入」より先にファイル整理で決まる。失敗しない準備チェックリスト

    社内資料をAIで検索できるようにしたい。過去の議事録、マニュアル、見積書、FAQ、業務メモを読み込ませて、質問すれば答えが返ってくる仕組みにしたい。

    この相談はかなり増えています。

    ただ、RAGやローカルLLM環境を作るときに、いきなりツール選定やモデル選びから始めると失敗しやすくなります。理由はシンプルで、AIが読む元データが整理されていないと、どれだけ良い仕組みを入れても回答がぶれやすいからです。

    社内RAGの品質は、AIそのものよりも「どの資料を、どの状態で、どの権限で読ませるか」に大きく左右されます。

    RAG導入でよく起きる失敗

    社内RAGでよくある失敗は、技術の問題に見えて、実際はデータ整理の問題であることが多いです。

    たとえば、次のような状態です。

    • 同じ内容の資料が複数あり、どれが最新版か分からない
    • 古いルールと新しいルールが混ざっている
    • PDF、Excel、Google Docs、メモが散らばっている
    • ファイル名だけでは中身が分からない
    • 社外秘、個人情報、顧客情報が混在している
    • 部署ごとに見せてよい情報が違う
    • AIに答えてほしくない資料まで入っている

    この状態でRAGを作ると、AIは「それらしい回答」は返します。しかし、その回答が現在有効なルールなのか、古い資料を元にしたものなのか、人間が判断しづらくなります。

    結果として、便利なはずのAI検索が「確認の手間が増えるツール」になってしまいます。

    まず決めるべきは「何を答えさせたいか」

    最初にやるべきことは、AIに読み込ませる資料を全部集めることではありません。

    先に決めるべきなのは、AIに何を答えさせたいかです。

    • 社内マニュアル検索
    • 顧客対応FAQ
    • 営業資料の検索
    • 過去案件のナレッジ検索
    • 経理・総務ルールの確認
    • 制作・開発手順の確認
    • 新人向けの業務質問対応

    用途が曖昧なまま「社内資料を全部AI化したい」と進めると、対象範囲が広がりすぎます。最初は1つの業務領域に絞ったほうが、回答精度も検証しやすくなります。

    ファイル整理で見るべき5つのポイント

    1. 最新版が分かるか

    RAGに入れる資料は、最新版が明確である必要があります。

    同じ名前のファイルが複数あったり、「最終版」「修正版」「最新版2」のようなファイルが残っていたりすると、AIが古い情報を拾う原因になります。

    最低限、次のような情報を整理しておくと扱いやすくなります。

    • 作成日
    • 更新日
    • 担当者
    • 現在も有効か
    • 廃止済みか
    • 関連部署
    • 文書の種類

    RAG構築前に、すべてを完璧に整理する必要はありません。ただし「古い資料かどうか分からない」状態のまま投入するのは避けたほうが安全です。

    2. ファイル名で中身が分かるか

    AIに読み込ませる前に、人間が見ても分かるファイル名にしておくことも重要です。

    悪い例:

    • memo.pdf
    • manual_new.xlsx
    • 2024修正済み.docx
    • 社内資料2.pdf

    良い例:

    • 経費精算ルール_2026年版.pdf
    • 顧客対応FAQ_返品交換_2026-04更新.docx
    • 営業提案テンプレート_SaaS向け_最新版.pptx

    ファイル名は、検索性と運用性に直結します。RAGの回答に参照元を表示する場合も、分かりやすいファイル名のほうが確認しやすくなります。

    3. 権限を分けられるか

    社内RAGでは、誰がどの情報を見てよいかを必ず考える必要があります。

    たとえば、経営資料、人事情報、顧客情報、契約情報、社内マニュアルを同じ扱いで入れると危険です。AI検索画面から、本来見せるべきでない情報が返ってしまう可能性があります。

    • 全社員向け
    • 特定部署向け
    • 管理者向け
    • 顧客情報を含む
    • 個人情報を含む
    • AI検索対象外

    RAGは便利ですが、社内検索である以上、情報漏えいリスクもあります。ローカルLLM環境を使う場合でも、権限設計を省略してよいわけではありません。

    4. AIに読ませない資料を決めているか

    RAG構築では「何を入れるか」だけでなく、「何を入れないか」も大事です。

    • 古い価格表
    • 廃止済みの手順書
    • 未確定のメモ
    • 個人情報を含むファイル
    • 顧客ごとの機密情報
    • 社内議論中のドラフト
    • 誤った内容を含む古いFAQ

    これらをそのまま入れると、AIが誤情報を元に回答する可能性があります。「AIに聞けば分かる」状態を作るには、AIが参照する資料の範囲を人間側で制御する必要があります。

    5. 回答の確認方法を決めているか

    RAGは、答えそのものだけでなく「どの資料を元に答えたか」を確認できる設計が重要です。

    • 回答の参照元ファイルを表示する
    • 該当箇所を引用・ハイライトする
    • 更新日を表示する
    • 信頼度が低い場合は断定しない
    • 参照元がない回答は出さない

    社内業務で使うAIは、雑談AIとは違います。それっぽく答えることより、確認できることのほうが重要です。

    小さく始めるなら「FAQ型RAG」がおすすめ

    最初のRAG導入では、いきなり全社ナレッジ検索を作るより、FAQ型から始めるのがおすすめです。

    • よくある社内手続き
    • 顧客対応の定型回答
    • サービス内容の説明
    • 制作依頼時の確認事項
    • 新人がよく聞く質問

    FAQ型は、質問と回答の品質を確認しやすく、改善もしやすいです。回答が間違っていた場合も、どの資料を直せばよいか判断しやすくなります。

    小さく作って、実際に使いながら改善する。この進め方のほうが、RAG導入は成功しやすくなります。

    nsd.meで相談できること

    nsd.me / YOSHIO.dev では、社内資料や業務ナレッジを活用したAI検索・RAG環境構築の相談を受け付けています。

    • 社内資料をAI検索できるようにしたい
    • ローカルLLMで社内データを扱いたい
    • RAGを導入したいが、何から始めるべきか分からない
    • PDFやGoogle Driveの資料を整理したい
    • 小規模な社内AIツールを作りたい
    • 既存業務に合わせてAI検索画面を作りたい

    最初から大きなシステムを作る必要はありません。まずは対象業務を絞り、使える資料を整理し、小さな検索ツールとして試すところから始めるのが現実的です。

    FAQ

    Q. RAGを作る前に、社内資料を全部整理する必要がありますか?

    いいえ。最初から全部整理する必要はありません。まずは対象業務を1つに絞り、その範囲の資料だけを整理するのがおすすめです。

    Q. 古い資料が多い場合でもRAGは作れますか?

    作れますが、古い資料と有効な資料を区別する必要があります。更新日や有効期限が分からない資料をそのまま入れると、誤回答の原因になります。

    Q. ローカルLLMを使えば情報漏えいの心配はなくなりますか?

    外部サービスに送信しない構成にはできますが、社内の権限管理や閲覧範囲の設計は別問題です。誰がどの資料を検索できるかは必ず設計する必要があります。

    Q. PDFやExcelもRAGに使えますか?

    使えます。ただし、表形式やスキャンPDFは抽出精度に差が出ます。必要に応じてテキスト化、形式変換、メタデータ付与を行うと精度が上がります。

    Q. まず何から相談すればよいですか?

    「どの業務でAI検索を使いたいか」「どの資料を元にしたいか」「誰が使うか」を整理して相談すると、具体的な構成を決めやすくなります。

    関連する内部リンク候補